
27 KiB
Instruction fine-tuning slovenského Mistral 7B modelu
Použitý model
Ako základný model bol použitý:
slovak-nlp/mistral-sk-7b
Výsledný adaptér z prvého experimentu je dostupný na Hugging Face:
Jakub1320/mistral-sk-7b-slovak-alpaca-qlora
Hardvér
Experimenty boli realizované na dvoch serveroch.
Titan
- 2× NVIDIA TITAN RTX
- 24 GB VRAM na GPU
- výpočty v
fp16
Hruška
- 2× NVIDIA RTX A4500
- približne 20 GB VRAM na GPU
- výpočty v
bf16
Prvý experiment – Slovak Alpaca
Použitý dataset
Na supervised fine-tuning bol v prvom experimente použitý slovenský inštrukčný dataset:
saillab/alpaca-slovak-cleaned
Dataset obsahuje polia:
instructioninputoutput
Dáta boli formátované v Alpaca štýle:
### Inštrukcia:
...

### Vstup:
...

### Odpoveď:
...
Metóda dotrénovania
Model bol dotrénovaný pomocou supervised fine-tuningu cez:
- Unsloth
- TRL
SFTTrainer - PEFT LoRA
- QLoRA štýl trénovania
Výsledkom tréningu je PEFT LoRA adaptér, ktorý sa pripája k základnému modelu slovak-nlp/mistral-sk-7b.
Hlavné hyperparametre prvého experimentu
| Parameter | Hodnota |
|---|---|
| Epochs | 1 |
| Max sequence length | 1024 |
| Batch size | 1 |
| Gradient accumulation | 8 |
| Effective batch size | 8 |
| Learning rate | 2e-4 |
| Optimizer | AdamW 8-bit |
| Scheduler | cosine |
| Warmup steps | 150 |
| LoRA rank | 16 |
| LoRA alpha | 32 |
| LoRA dropout | 0.05 |
| Quantization | 4-bit |
| Compute type | fp16 |
Použité LoRA cieľové moduly:
q_proj, k_proj, v_proj, o_proj, gate_proj, up_proj, down_proj
Vyhodnotenie pomocou vlastného evaluačného skriptu
Model bol vyhodnotený na testovacích príkladoch z datasetu saillab/alpaca-slovak-cleaned pomocou metrík ROUGE, BLEU, eval loss a perplexity.
| Metrika | Výsledok |
|---|---|
| ROUGE-1 | 0.3710 |
| ROUGE-2 | 0.1702 |
| ROUGE-L | 0.2732 |
| BLEU | 6.2850 |
| Eval loss | 0.8081 |
| Perplexity | 2.2435 |
Vyhodnotenie pomocou lm-evaluation-harness
Hodnotený bol PEFT LoRA adaptér pripojený k základnému modelu:
slovak-nlp/mistral-sk-7b
+
Jakub1320/mistral-sk-7b-slovak-alpaca-qlora
Použité benchmarky
| Benchmark | Popis |
|---|---|
arc_sk |
slovenské vedecké/školské otázky s výberom odpovede |
hellaswag_sk |
commonsense reasoning a výber najpravdepodobnejšieho pokračovania |
m_mmlu_sk |
slovenský všeobecný vedomostný benchmark |
truthfulqa_sk_mc1 |
hodnotenie pravdivosti odpovedí, multiple choice MC1 |
truthfulqa_sk_mc2 |
hodnotenie pravdivosti odpovedí, multiple choice MC2 |
sklegal |
slovenské právne otázky s výberom odpovede |
skquad |
slovenský question-answering benchmark |
Úlohy sklegal a skquad boli doplnené ako custom tasky.
Výsledky lm-evaluation-harness
Poznámka: výsledky arc_sk, hellaswag_sk, m_mmlu_sk a TruthfulQA pochádzajú z prvého behu. sklegal a skquad boli následne dopočítané v druhom samostatnom behu nad tým istým Alpaca QLoRA adaptérom, pretože v pôvodnom behu tieto dve custom úlohy nefungovali.
| Task | Počet vzoriek | Metrika | Výsledok |
|---|---|---|---|
arc_sk |
1169 | acc | 0.3259 |
arc_sk |
1169 | acc_norm | 0.3473 |
hellaswag_sk |
9485 | acc | 0.4134 |
hellaswag_sk |
9485 | acc_norm | 0.5106 |
m_mmlu_sk |
13062 | acc | 0.2928 |
truthfulqa_sk_mc1 |
778 | acc | 0.2391 |
truthfulqa_sk_mc2 |
778 | acc | 0.3942 |
sklegal |
1334 | acc | 0.2841 |
sklegal |
1334 | acc_norm | 0.4693 |
skquad |
9583 | exact | 1.9722 |
skquad |
9583 | f1 | 27.7994 |
skquad |
9583 | HasAns_exact | 2.4106 |
skquad |
9583 | HasAns_f1 | 34.1456 |
skquad |
9583 | NoAns_exact | 0.0561 |
skquad |
9583 | NoAns_f1 | 0.0561 |
skquad |
9583 | best_exact | 18.6163 |
skquad |
9583 | best_f1 | 28.3012 |
Experiment so strojovým prekladom datasetu
Cieľom experimentu bolo vyskúšať postup, pri ktorom sa anglické polia datasetu:
instructioninputoutput
automaticky preložia do slovenčiny a uložia do novej dátovej množiny so zachovaním pôvodnej štruktúry.
Výstupný formát obsahoval pôvodné anglické texty aj slovenské preklady:
{
  "instruction_en": "...",
  "input_en": "...",
  "output_en": "...",
  "instruction_sk": "...",
  "input_sk": "...",
  "output_sk": "..."
}
Vznikla preložená vzorka datasetu s 1000 príkladmi.
Umiestnenie:
strojovy_preklad/translated_datasets/alpaca_translated_en_sk_1000.jsonl
Experiment s datasetom Aya Collection
Pre ďalšie experimenty bol použitý dataset:
CohereLabs/aya_collection_language_split- subset:
slovak
Používané polia boli mapované nasledovne:
| Pôvodné pole | Použitie pri tréningu |
|---|---|
inputs |
prompt / inštrukcia |
targets |
odpoveď |
Prvý dlhý Aya tréning na serveri Titan – manuálne ukončený pokus
Pred úspešným 225 000-krokovým tréningom bol na serveri Titan spustený prvý dlhý tréning nad slovenskou časťou datasetu Aya Collection.
Tento experiment bežal na jednej NVIDIA TITAN RTX a používal streaming datasetu. Konfiguráčny súbor je
train_mistral_sk_aya_slovak_full_lora.yaml
Konfigurácia prvého dlhého tréningu
| Parameter | Hodnota |
|---|---|
| Base model | slovak-nlp/mistral-sk-7b |
| Dataset | aya_slovak_full |
| Template | alpaca |
| Fine-tuning | LoRA |
| GPU | 1× NVIDIA TITAN RTX |
| Max sequence length | 1024 |
| Streaming | áno |
| Streaming buffer | 16 384 |
| Batch size per device | 1 |
| Gradient accumulation | 4 |
| Effective batch size | 4 |
| Max steps | 1 037 000 |
| Learning rate | 2e-4 |
| Scheduler | cosine |
| Warmup steps | 500 |
| Max grad norm | 1.0 |
| Optimizer | AdamW 8-bit |
| LoRA rank | 16 |
| LoRA alpha | 32 |
| LoRA dropout | 0.05 |
| Compute type | fp16 |
| Unsloth | áno |
| Unsloth gradient checkpointing | áno |
| Validation size | 1000 |
| Eval interval | každých 50 000 krokov |
| Save interval | každých 10 000 krokov |
| Save total limit | 2 |
Použité LoRA cieľové moduly:
q_proj, k_proj, v_proj, o_proj, gate_proj, up_proj, down_proj
Konfigurácia počítala približne s jedným prechodom cez celý slovenský Aya subset:
4 148 187 príkladov / effective batch 4 ≈ 1 037 000 krokov
Dôvod manuálneho ukončenia
Tréning technicky nespadol. Po približne 94 000 krokoch sa však začala výrazne zhoršovať stabilita optimalizácie.
V logu sa objavili extrémne hodnoty grad_norm, napríklad:
grad_norm = 125.6
grad_norm = 105.9
grad_norm = 24000
grad_norm = 772.1
grad_norm = 11410
grad_norm = 2714
grad_norm = nan
Súčasne začal výrazne kolísať aj training loss, napríklad:
loss = 3.232
loss = 7.081
loss = 5.206
loss = 14.82
Neskôr sa v logu objavila aj kombinácia:
loss = 0.0
grad_norm = nan
Keďže tréning vykazoval známky numerickej nestability, bol manuálne ukončený približne pri kroku 104 238 z plánovaných 1 037 000, teda približne po 10 % tréningu.
V čase ukončenia bol runtime približne:
44 hodín 48 minút
Tento experiment ukázal, že pôvodné nastavenie nebolo vhodné na pokračovanie v takto dlhom tréningu bez ďalších úprav.
Dlhý Aya tréning na serveri Titan
Na serveri Titan bol spustený dlhý LoRA fine-tuning nad slovenskou časťou Aya Collection.
Na rozdiel od prvého QLoRA experimentu nebola použitá 4-bit kvantizácia.
Hlavná konfigurácia
| Parameter | Hodnota |
|---|---|
| Base model | slovak-nlp/mistral-sk-7b |
| Dataset | Aya Collection – Slovak |
| Fine-tuning | LoRA |
| Unsloth | áno |
| GPU | 2× NVIDIA TITAN RTX |
| Batch size per device | 1 |
| Gradient accumulation | 8 |
| Effective batch size | 16 |
| Max sequence length | 1024 |
| Max steps | 225 000 |
| Learning rate | 5e-5 |
| Scheduler | cosine |
| Warmup steps | 10 000 |
| LoRA rank | 16 |
| LoRA alpha | 16 |
| LoRA dropout | 0.0 |
| Compute type | fp16 |
| Streaming | áno |
Použité LoRA cieľové moduly:
q_proj, k_proj, v_proj, o_proj, gate_proj, up_proj, down_proj
Tréning úspešne dobehol do kroku 225000.
Pri effective batch size 16 bolo do tohto bodu spracovaných približne:
225 000 × 16 = 3 600 000 príkladov
To predstavuje približne 86,8 % slovenského Aya datasetu s približne 4,148 milióna príkladmi. Nešlo teda o úplný jeden epoch.
Eval loss počas Titan tréningu
| Krok | Eval loss |
|---|---|
| 25 000 | 1.0599 |
| 50 000 | 1.174 |
| 75 000 | 1.284 |
| 100 000 | 1.429 |
| 125 000 | 1.342 |
| 150 000 | 1.323 |
| 175 000 | 1.321 |
| 200 000 | 1.213 |
| 225 000 | 1.221 |
Najnižší validačný loss bol zaznamenaný pri kroku 25000. Tento checkpoint bol samostatne zachovaný pre ďalšie benchmarkové porovnanie s finálnym modelom.
Hruška – 10 porovnávacích experimentov
Na serveri Hruška bola vytvorená séria menších experimentov s cieľom porovnať vplyv vybraných hyperparametrov LoRA fine-tuningu.
Cieľom bolo porovnať vplyv:
- learning rate,
- LoRA rank,
- LoRA alpha,
- optimalizátora,
- LoRA target modulov,
- batch size a gradient accumulation.
Fixný dataset
Pre férové porovnanie všetkých experimentov bol vytvorený fixný dataset:
aya_slovak_100k_fixed.jsonl
Dataset obsahuje presne 100 000 slovenských príkladov z Aya Collection.
Pri jeho vytvorení bol použitý fixný seed. Samotné experimenty už nepoužívali streaming, takže všetky konfigurácie pracovali s rovnakým poolom dát.
Dáta boli uložené vo formáte:
{
  "instruction": "...",
  "input": "",
  "output": "..."
}
Pri tréningu bolo 1000 príkladov použitých na validáciu.
Spoločné nastavenia experimentov
| Parameter | Hodnota |
|---|---|
| Base model | slovak-nlp/mistral-sk-7b |
| Dataset | aya_slovak_100k_fixed |
| GPU | 2× NVIDIA RTX A4500 |
| Fine-tuning | LoRA |
| Unsloth | áno |
| Streaming | nie |
| Max sequence length | 1024 |
| Max steps | 6250 |
| Effective batch size | 16 |
| Scheduler | cosine |
| Warmup steps | 500 |
| Max grad norm | 0.5 |
| LoRA dropout | 0.0 |
| Compute type | bf16 |
| Eval interval | každých 1250 krokov |
| Validation size | 1000 |
| Seed | 42 |
Štandardné LoRA cieľové moduly:
q_proj, k_proj, v_proj, o_proj, gate_proj, up_proj, down_proj
Výnimkou je experiment 08, ktorý používa iba:
q_proj, k_proj, v_proj, o_proj
Porovnávané konfigurácie
| Experiment | Hlavná zmena |
|---|---|
01_baseline_r16_a16_lr5e5_adamw |
baseline: rank 16, alpha 16, LR 5e-5, AdamW |
02_optimizer_adamw8bit_r16_a16_lr5e5 |
AdamW 8-bit |
03_rank8_a16_lr5e5 |
LoRA rank 8 |
04_rank32_a32_lr5e5 |
LoRA rank 32, alpha 32 |
05_r16_alpha32_lr5e5 |
alpha 32 pri rank 16 |
06_lr1e4_r16_a16 |
learning rate 1e-4 |
07_lr2e5_r16_a16 |
learning rate 2e-5 |
08_attention_only_r16_a16_lr5e5 |
LoRA iba na attention projekciách |
09_batch2_accum4_r16_a16_lr5e5 |
batch size 2, gradient accumulation 4 |
10_r16_a32_lr1e4 |
kombinácia alpha 32 + learning rate 1e-4 |
Výsledky Hruška experimentov
| Experiment | Train loss | Eval loss | Runtime |
|---|---|---|---|
01_baseline_r16_a16_lr5e5_adamw |
0.9290 | 0.7567 | 7:18:05 |
02_optimizer_adamw8bit_r16_a16_lr5e5 |
0.9248 | 0.7521 | 7:20:23 |
03_rank8_a16_lr5e5 |
0.9308 | 0.7586 | 7:16:23 |
04_rank32_a32_lr5e5 |
0.9003 | 0.7292 | 7:22:33 |
05_r16_alpha32_lr5e5 |
0.9026 | 0.7323 | 7:17:44 |
06_lr1e4_r16_a16 |
0.8890 | 0.7184 | 7:17:30 |
07_lr2e5_r16_a16 |
0.9674 | 0.7912 | 7:18:25 |
08_attention_only_r16_a16_lr5e5 |
0.9808 | 0.8094 | 6:51:25 |
09_batch2_accum4_r16_a16_lr5e5 |
0.9290 | 0.7563 | 8:24:57 |
10_r16_a32_lr1e4 |
0.8612 | 0.6918 | približne 7:15 h |
Najnižší finálny eval_loss dosiahol experiment:
10_r16_a32_lr1e4
s hodnotou:
eval_loss = 0.6918
V tomto experimente bola použitá kombinácia:
LoRA rank = 16
LoRA alpha = 32
learning rate = 1e-4
optimizer = AdamW
effective batch size = 16
Pozorované rozdiely
Z doterajších výsledkov:
- zvýšenie learning rate z
5e-5na1e-4znížilo eval loss z0.7567na0.7184, - zvýšenie LoRA alpha z
16na32pri rank 16 znížilo eval loss na0.7323, - kombinácia
alpha=32alearning_rate=1e-4dosiahla najnižší eval loss0.6918, - rank 32 priniesol eval loss
0.7292, - rank 8 dosiahol výsledok veľmi blízky baseline,
- attention-only LoRA bola rýchlejšia, ale mala vyšší eval loss,
- zmena z batch size 1 / accumulation 8 na batch size 2 / accumulation 4 nepriniesla zlepšenie validačného lossu ani runtime.
Súbory Hruška experimentov
Výsledky experimentov sú uložené v priečinku:
hruska_10_experiments_results/
Súčasťou sú:
hruska_10_experiments_results/
├── aya_slovak_100k_fixed/
├── hruska_10_experiments_results/
│   ├── 01_baseline_r16_a16_lr5e5_adamw/
│   ├── 02_optimizer_adamw8bit_r16_a16_lr5e5/
│   ├── 03_rank8_a16_lr5e5/
│   ├── 04_rank32_a32_lr5e5/
│   ├── 05_r16_alpha32_lr5e5/
│   ├── 06_lr1e4_r16_a16/
│   ├── 07_lr2e5_r16_a16/
│   ├── 08_attention_only_r16_a16_lr5e5/
│   ├── 09_batch2_accum4_r16_a16_lr5e5/
│   └── 10_r16_a32_lr1e4/
├── hruska_experiment_eval_loss_ranking.png
├── hruska_experiment_train_loss_ranking.png
└── hruska_experiment_summary.csv
Každý experiment obsahuje:
<experiment>.yaml
training.log
training_loss.png
training_eval_loss.png
Reprodukcia tréningových experimentov
Jednotlivé experimenty je možné zreplikovať pomocou uložených YAML konfiguračných súborov.
Pred spustením tréningu je potrebné aktivovať prostredie s LLaMA-Factory a prejsť do jeho adresára:
conda activate llama_factory_unsloth
cd /home/schwarc/LLaMA-Factory
Pre 2-GPU experimenty bol tréning spúšťaný pomocou:
CUDA_VISIBLE_DEVICES=0,1 FORCE_TORCHRUN=1 \
llamafactory-cli train /cesta/ku/configu.yaml
Napríklad pre experiment:
10_r16_a32_lr1e4
možno použiť:
CUDA_VISIBLE_DEVICES=0,1 FORCE_TORCHRUN=1 \
llamafactory-cli train \
/home/schwarc/diplomovka/configs/hruska_compare9_100k_fixed/10_r16_a32_lr1e4.yaml
Ak má byť terminálový výstup zároveň uložený do logu:
CUDA_VISIBLE_DEVICES=0,1 FORCE_TORCHRUN=1 \
llamafactory-cli train \
/home/schwarc/diplomovka/configs/hruska_compare9_100k_fixed/10_r16_a32_lr1e4.yaml \
2>&1 | tee /home/schwarc/diplomovka/logs/10_r16_a32_lr1e4.log
Výsledky benchmarkovania pomocou lm-evaluation-harness
Po dokončení tréningov boli vyhodnotené:
- všetkých 10 Hruška experimentov,
- Titan checkpoint po 25 000 krokoch,
- finálny Titan model po 225 000 krokoch,
- starší QLoRA model trénovaný na
saillab/alpaca-slovak-cleaned. - Kompletné výsledky a výstupné súbory z evaluácie pomocou lm-evaluation-harness sú dostupné v priečinku
lmeval/
Použité benchmarky:
arc_sk
hellaswag_sk
m_mmlu_sk
truthfulqa_sk_mc1
truthfulqa_sk_mc2
sklegal
skquad
Počet hodnotených vzoriek bol:
| Benchmark | Počet vzoriek |
|---|---|
arc_sk |
1169 |
hellaswag_sk |
9485 |
m_mmlu_sk |
13062 |
truthfulqa_sk_mc1 |
778 |
truthfulqa_sk_mc2 |
778 |
sklegal |
1334 |
skquad |
9583 |
Pri úlohách, kde lm-evaluation-harness poskytuje acc aj acc_norm, je v súhrnných tabuľkách použitá najmä hodnota acc_norm. Pri skquad je ako hlavná súhrnná metrika použitá hodnota F1.
Hruška benchmarky boli počítané v bfloat16, Titan a starší Alpaca model v float16. Batch size pri evaluácii bol 1.
Poznámka k staršiemu Alpaca benchmarku
Starší model Jakub1320/mistral-sk-7b-slovak-alpaca-qlora bol vyhodnotený v dvoch behoch. V prvom boli vyhodnotené:
arc_sk
hellaswag_sk
m_mmlu_sk
truthfulqa_sk_mc1
truthfulqa_sk_mc2
Úlohy sklegal a skquad vtedy nefungovali, preto boli neskôr spustené samostatne. Výsledky uvedené v README sú zlúčením týchto dvoch behov nad tým istým adaptérom.
Pri porovnávaní starého Alpaca modelu s novšími behmi treba brať do úvahy, že bol použitý iný softvérový stav. Najdôležitejšie je, že starý výsledok truthfulqa_sk_mc2 má v uloženom výsledku verziu úlohy 2.0, zatiaľ čo novšie Hruška a Titan behy používajú verziu 1.0. Preto výsledok MC2 starého Alpaca modelu nie je vhodné považovať za úplne priamo porovnateľný s novými behmi. Ostatné hlavné verzie benchmarkov sa zhodujú.
Výsledky 10 Hruška experimentov
| Experiment | Eval loss | ARC acc_norm | HellaSwag acc_norm | M-MMLU acc | TQA MC1 | TQA MC2 | SKLegal acc_norm | SKQuad F1 |
|---|---|---|---|---|---|---|---|---|
01_baseline_r16_a16_lr5e5_adamw |
0.7567 | 0.3405 | 0.5209 | 0.3550 | 0.1799 | 0.3439 | 0.4685 | 36.6797 |
02_optimizer_adamw8bit_r16_a16_lr5e5 |
0.7521 | 0.3379 | 0.5212 | 0.3544 | 0.1928 | 0.3537 | 0.4715 | 36.2178 |
03_rank8_a16_lr5e5 |
0.7586 | 0.3311 | 0.5167 | 0.3455 | 0.1838 | 0.3425 | 0.4715 | 36.3638 |
04_rank32_a32_lr5e5 |
0.7292 | 0.3353 | 0.5201 | 0.3450 | 0.1902 | 0.3367 | 0.4730 | 36.0228 |
05_r16_alpha32_lr5e5 |
0.7323 | 0.3336 | 0.5190 | 0.3571 | 0.1967 | 0.3555 | 0.4670 | 37.8735 |
06_lr1e4_r16_a16 |
0.7184 | 0.3311 | 0.5207 | 0.3550 | 0.1902 | 0.3473 | 0.4655 | 37.5796 |
07_lr2e5_r16_a16 |
0.7912 | 0.3276 | 0.5225 | 0.3379 | 0.1671 | 0.3246 | 0.4723 | 33.8381 |
08_attention_only_r16_a16_lr5e5 |
0.8094 | 0.3524 | 0.5218 | 0.3448 | 0.1877 | 0.3674 | 0.4768 | 43.3752 |
09_batch2_accum4_r16_a16_lr5e5 |
0.7563 | 0.3379 | 0.5209 | 0.3514 | 0.1864 | 0.3402 | 0.4693 | 35.3128 |
10_r16_a32_lr1e4 |
0.6918 | 0.3293 | 0.5157 | 0.3448 | 0.2057 | 0.3480 | 0.4618 | 37.7561 |
Najlepší výsledok Hruška podľa jednotlivých benchmarkov
| Metrika | Najlepší Hruška experiment | Výsledok |
|---|---|---|
| ARC acc_norm | 08_attention_only_r16_a16_lr5e5 |
0.3524 |
| HellaSwag acc_norm | 07_lr2e5_r16_a16 |
0.5225 |
| M-MMLU acc | 05_r16_alpha32_lr5e5 |
0.3571 |
| TruthfulQA MC1 | 10_r16_a32_lr1e4 |
0.2057 |
| TruthfulQA MC2 | 08_attention_only_r16_a16_lr5e5 |
0.3674 |
| SKLegal acc_norm | 08_attention_only_r16_a16_lr5e5 |
0.4768 |
| SKQuad F1 | 08_attention_only_r16_a16_lr5e5 |
43.3752 |
Najvýraznejší výsledok dosiahol experiment:
08_attention_only_r16_a16_lr5e5
Ten mal síce zo všetkých 10 experimentov najvyšší, teda najhorší validačný eval_loss = 0.8094, ale súčasne dosiahol najlepší Hruška výsledok na:
arc_skpodľaacc_norm,truthfulqa_sk_mc2,sklegalpodľaacc_norm,skquadpodľa F1.
Na skquad dosiahol F1 43.3752, zatiaľ čo baseline experiment 01 dosiahol 36.6797.
Naopak experiment:
10_r16_a32_lr1e4
mal najlepší validačný eval_loss = 0.6918, ale nebol najlepší vo väčšine externých benchmarkov. Jeho najlepší výsledok v rámci Hruška experimentov bol truthfulqa_sk_mc1 = 0.2057.
Ďalšie pozorovania:
07_lr2e5_r16_a16dosiahol najlepší HellaSwagacc_norm = 0.5225, ale mal slabší eval loss0.7912.05_r16_alpha32_lr5e5dosiahol najlepší M-MMLU výsledok0.3571.- AdamW 8-bit v experimente 02 dal benchmarkové výsledky veľmi podobné klasickému AdamW baseline.
- zmena batch size / gradient accumulation v experimente 09 nepriniesla jasné benchmarkové zlepšenie,
- rozdiely medzi viacerými Hruška modelmi na multiple-choice úlohách sú malé, preto ich netreba interpretovať ako zásadné bez ďalších behov alebo štatistického testovania,
- najvýraznejšie oddelenie experimentu 08 je na
skquad, kde je rozdiel oproti ostatným modelom podstatne väčší.
Porovnanie Titan checkpointu 25k a finálneho modelu 225k
Checkpoint 25 000 zodpovedá približne:
25 000 × effective batch size 16 = 400 000 spracovaných tréningových príkladov
Finálny krok 225 000 zodpovedá približne:
225 000 × 16 = 3 600 000 spracovaných tréningových príkladov
Slovenská časť Aya obsahuje približne 4,148 milióna príkladov, takže 225 000 krokov predstavuje približne 86,8 % jedného úplného prechodu datasetom, nie celý epoch.
| Metrika | Titan 25k | Titan 225k | Zmena 225k − 25k |
|---|---|---|---|
| ARC acc_norm | 0.3251 | 0.3447 | +1.97 p. b. |
| HellaSwag acc_norm | 0.4943 | 0.4793 | -1.50 p. b. |
| M-MMLU acc | 0.3342 | 0.2719 | -6.22 p. b. |
| TruthfulQA MC1 | 0.1761 | 0.2005 | +2.44 p. b. |
| TruthfulQA MC2 | 0.3251 | 0.3613 | +3.63 p. b. |
| SKLegal acc_norm | 0.4588 | 0.4393 | -1.95 p. b. |
| SKQuad F1 | 25.8678 | 35.0471 | +9.1793 bodu |
Výsledok Titan porovnania nie je jednoznačný.
Finálny 225k model oproti 25k checkpointu zlepšil:
- ARC
acc_normpribližne o 1,97 percentuálneho bodu, - TruthfulQA MC1 približne o 2,44 p. b.,
- TruthfulQA MC2 približne o 3,63 p. b.,
- SKQuad F1 približne o 9,18 bodu.
Naopak sa zhoršil:
- HellaSwag
acc_normpribližne o 1,50 p. b., - M-MMLU približne o 6,22 p. b.,
- SKLegal
acc_normpribližne o 1,95 p. b.
To je dôležité aj vzhľadom na validačný loss. Checkpoint 25k mal najlepší nameraný Titan eval loss približne 1.0599, zatiaľ čo na konci bol eval loss približne 1.221. Napriek tomu 225k checkpoint zlepšil niektoré downstream úlohy, najmä skquad.
Preto sa nedá povedať, že checkpoint s najnižším validačným lossom je automaticky najlepší model pre všetky úlohy.
Súhrnné porovnanie vybraných modelov
| Model / checkpoint | ARC acc_norm | HellaSwag acc_norm | M-MMLU acc | TQA MC1 | TQA MC2 | SKLegal acc_norm | SKQuad F1 |
|---|---|---|---|---|---|---|---|
| Alpaca QLoRA | 0.3473 | 0.5106 | 0.2928 | 0.2391 | 0.3942 * | 0.4693 | 27.7994 |
| Hruška 08 attention-only | 0.3524 | 0.5218 | 0.3448 | 0.1877 | 0.3674 | 0.4768 | 43.3752 |
| Hruška 10 best eval loss | 0.3293 | 0.5157 | 0.3448 | 0.2057 | 0.3480 | 0.4618 | 37.7561 |
| Titan 25k | 0.3251 | 0.4943 | 0.3342 | 0.1761 | 0.3251 | 0.4588 | 25.8678 |
| Titan 225k | 0.3447 | 0.4793 | 0.2719 | 0.2005 | 0.3613 | 0.4393 | 35.0471 |
* Starý Alpaca výsledok truthfulqa_sk_mc2 bol získaný s inou verziou tejto úlohy, preto ho treba porovnávať opatrne.
Z porovnania možno vyvodiť:
-
Hruška experimenty sú veľmi konkurencieschopné napriek iba 100k dátam.
Najmä experiment 08 dosiahol najlepší výsledok naskquada silné výsledky na ARC a SKLegal. -
Viac tréningových dát alebo viac krokov automaticky neznamenalo lepší výsledok na každom benchmarku.
Titan 225k spracoval približne 3,6 milióna príkladov, ale na M-MMLU, HellaSwag a SKLegal bol slabší než viacero 100k Hruška experimentov. -
Titan 225k sa výrazne zlepšil v generatívnom question-answering benchmarku SKQuad oproti Titan 25k.
F1 stúplo z25.8678na35.0471. -
Starší Alpaca QLoRA model zostáva silný na TruthfulQA MC1.
Dosiahol0.2391, čo je viac než všetky nové Aya experimenty. To môže znamenať, že rozdielna tréningová dátová distribúcia zachováva alebo posilňuje iné schopnosti modelu. -
Najlepší Hruška validačný loss a najlepší benchmarkový model nie sú totožné.
Experiment 10 je najlepší podľa Aya eval loss, zatiaľ čo experiment 08 je najvýraznejší podľa širšieho benchmarkového profilu.
Dôležité obmedzenia porovnania
Pri interpretácii výsledkov treba zohľadniť:
- Hruška modely boli trénované na fixnom 100k výbere Aya dát, Titan na streamovanej veľkej časti Aya datasetu,
- konfigurácie tréningu sa medzi Hruškou a Titanom líšili,
- Hruška benchmarky používali
bf16, Titanfp16, - starší Alpaca benchmark vznikol v inom softvérovom prostredí,
- starý
truthfulqa_sk_mc2používal inú verziu úlohy, - nebol zatiaľ zrobený benchmark základného modelu
slovak-nlp/mistral-sk-7bbez adaptéru.
Optuna – výber learning rate na 30k Aya príkladoch
Po sérii 100k porovnávacích experimentov som na Hruške vyskúšal menší skúšobný experiment s automatickým výberom learning rate pomocou framewrku Optuna. Cieľom bolo vybrať sľubnú oblasť LR pre následné overenie na väčšej dátovej množine. Táto časť sumarizuje osem úspešne dokončených trialov.
Konfigurácie, súhrnné výsledky, grafy a podrobné záznamy úspešných trialov sú v priečinku optuna_30k_experiments/.
Tréningové logy všetkých ôsmich dokončených trialov sú v priečinku logs/.
Metodika a spoločné nastavenia
Optimalizovaný bol iba parameter learning_rate v rozsahu 2e-5 až 2e-4. Prvé štyri referenčné hodnoty boli vložené ručne: 2e-5, 5e-5, 1e-4 a 2e-4. Ďalšie hodnoty navrhovala Optuna.
| Parameter | Hodnota |
|---|---|
| Základný model | slovak-nlp/mistral-sk-7b |
| Dataset | fixný aya_slovak_hpo_30k, bez streamingu |
| Rozdelenie dát | 29 000 tréningových + 1 000 validačných príkladov |
| Hardvér | 1× NVIDIA RTX A4500 na Hruške, GPU 0 |
| Compute type | bf16 |
| Framework | LLaMA-Factory + Unsloth |
| Fine-tuning | LoRA, bez nastavenej 4-bit kvantizácie |
| Template / max. dĺžka | alpaca / 1024 tokenov |
| Packing / train on prompt | false / false |
| LoRA rank / alpha / dropout | 16 / 32 / 0.0 |
| LoRA target moduly | q_proj,k_proj,v_proj,o_proj,gate_proj,up_proj,down_proj |
| Batch size / gradient accumulation | 1 / 16, effective batch 16 |
| Rozsah tréningu | 1 epocha, 1 813 optimizer krokov |
| Optimizer / scheduler | AdamW (adamw_torch) / cosine |
| Warmup | 150 krokov |
| Max grad norm | 0.5 |
| Eval interval / eval batch size | každých 300 krokov + finálna evaluácia / 1 |
| Seed | 42 |
Výsledky ôsmich dokončených trialov
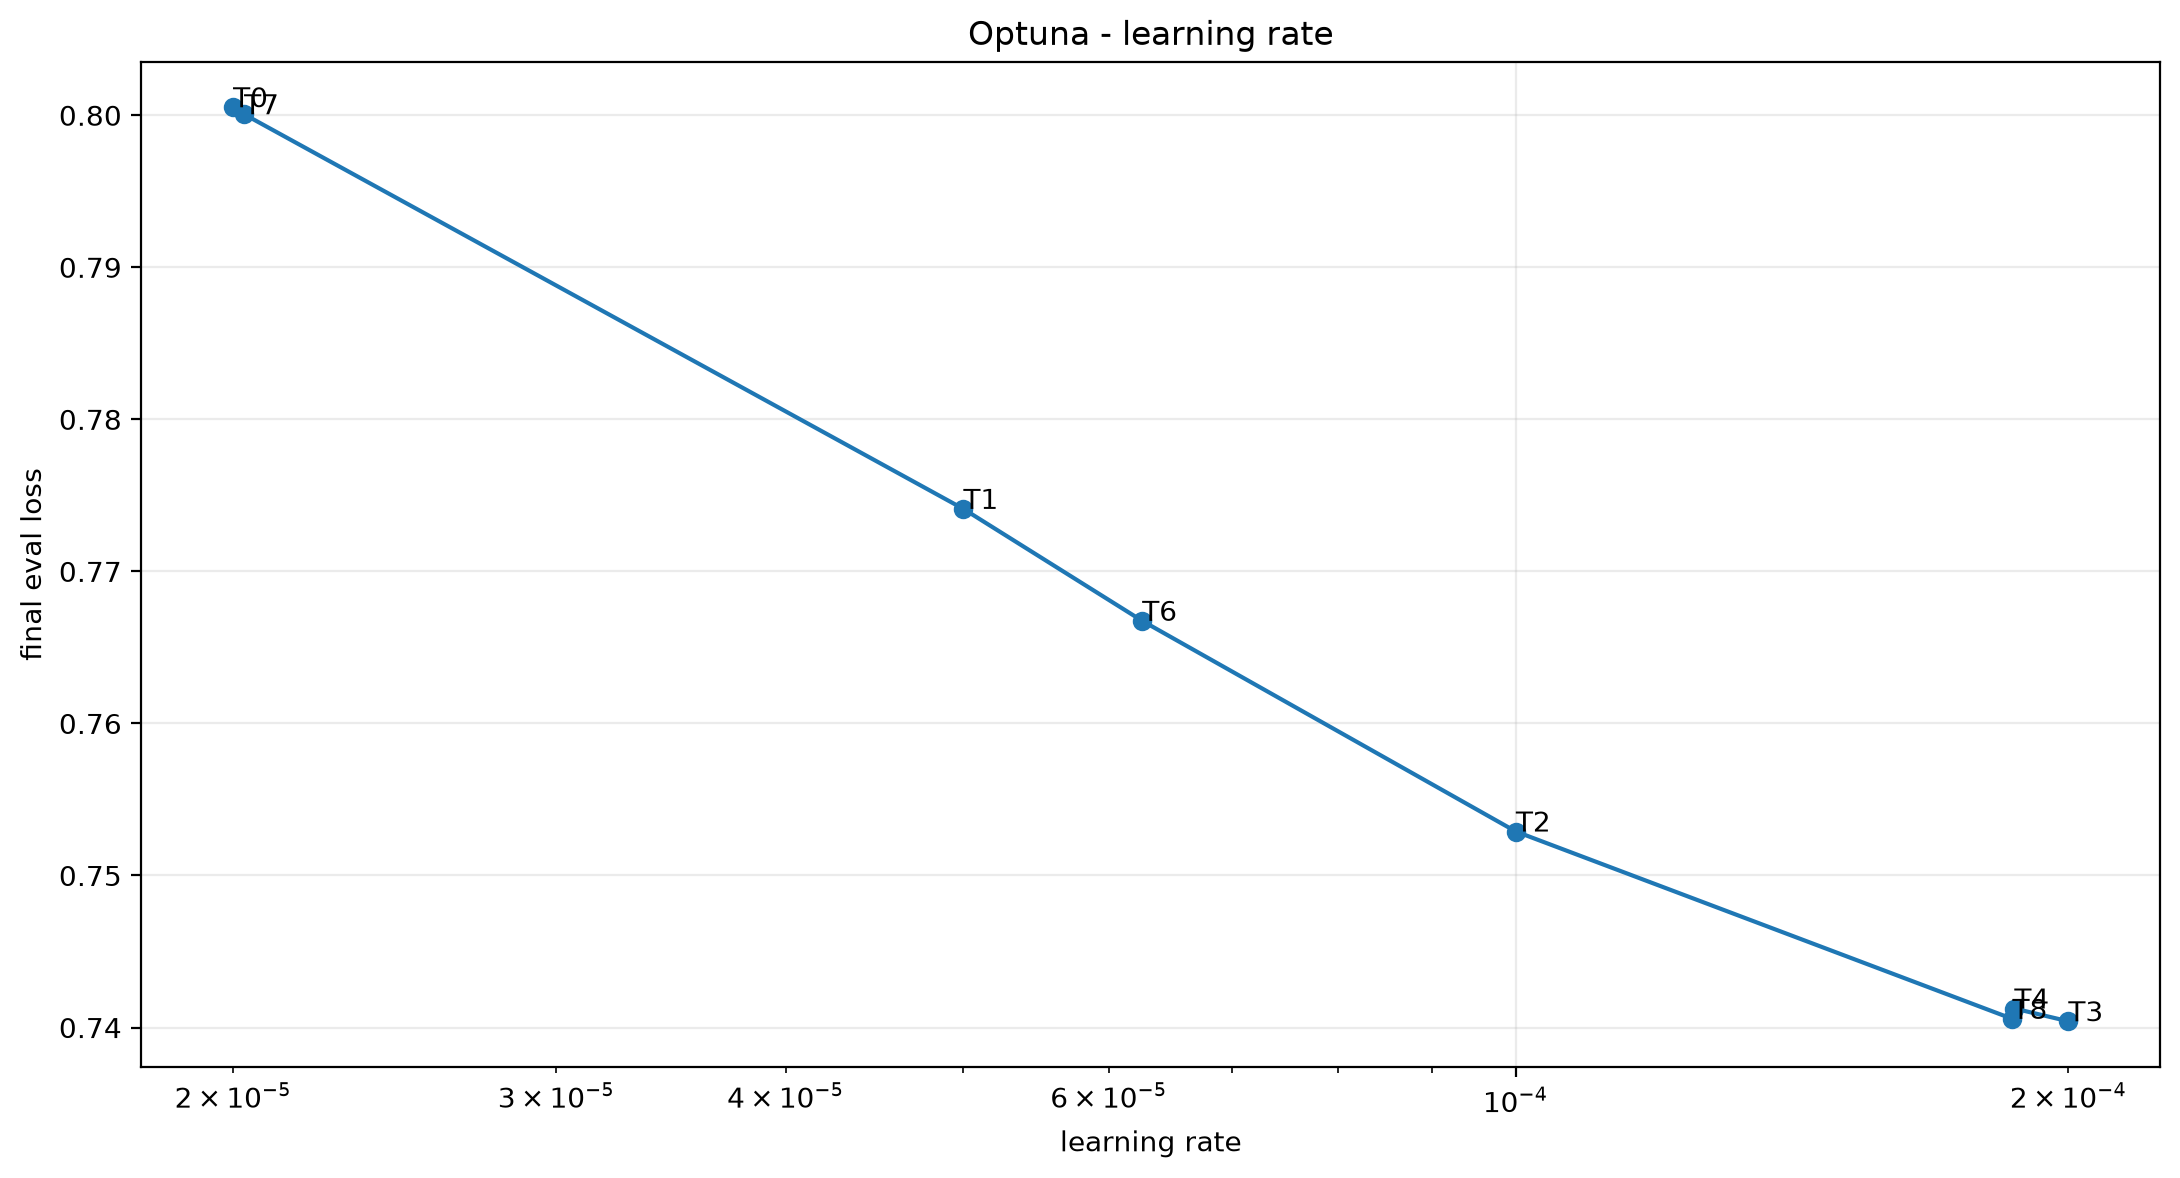
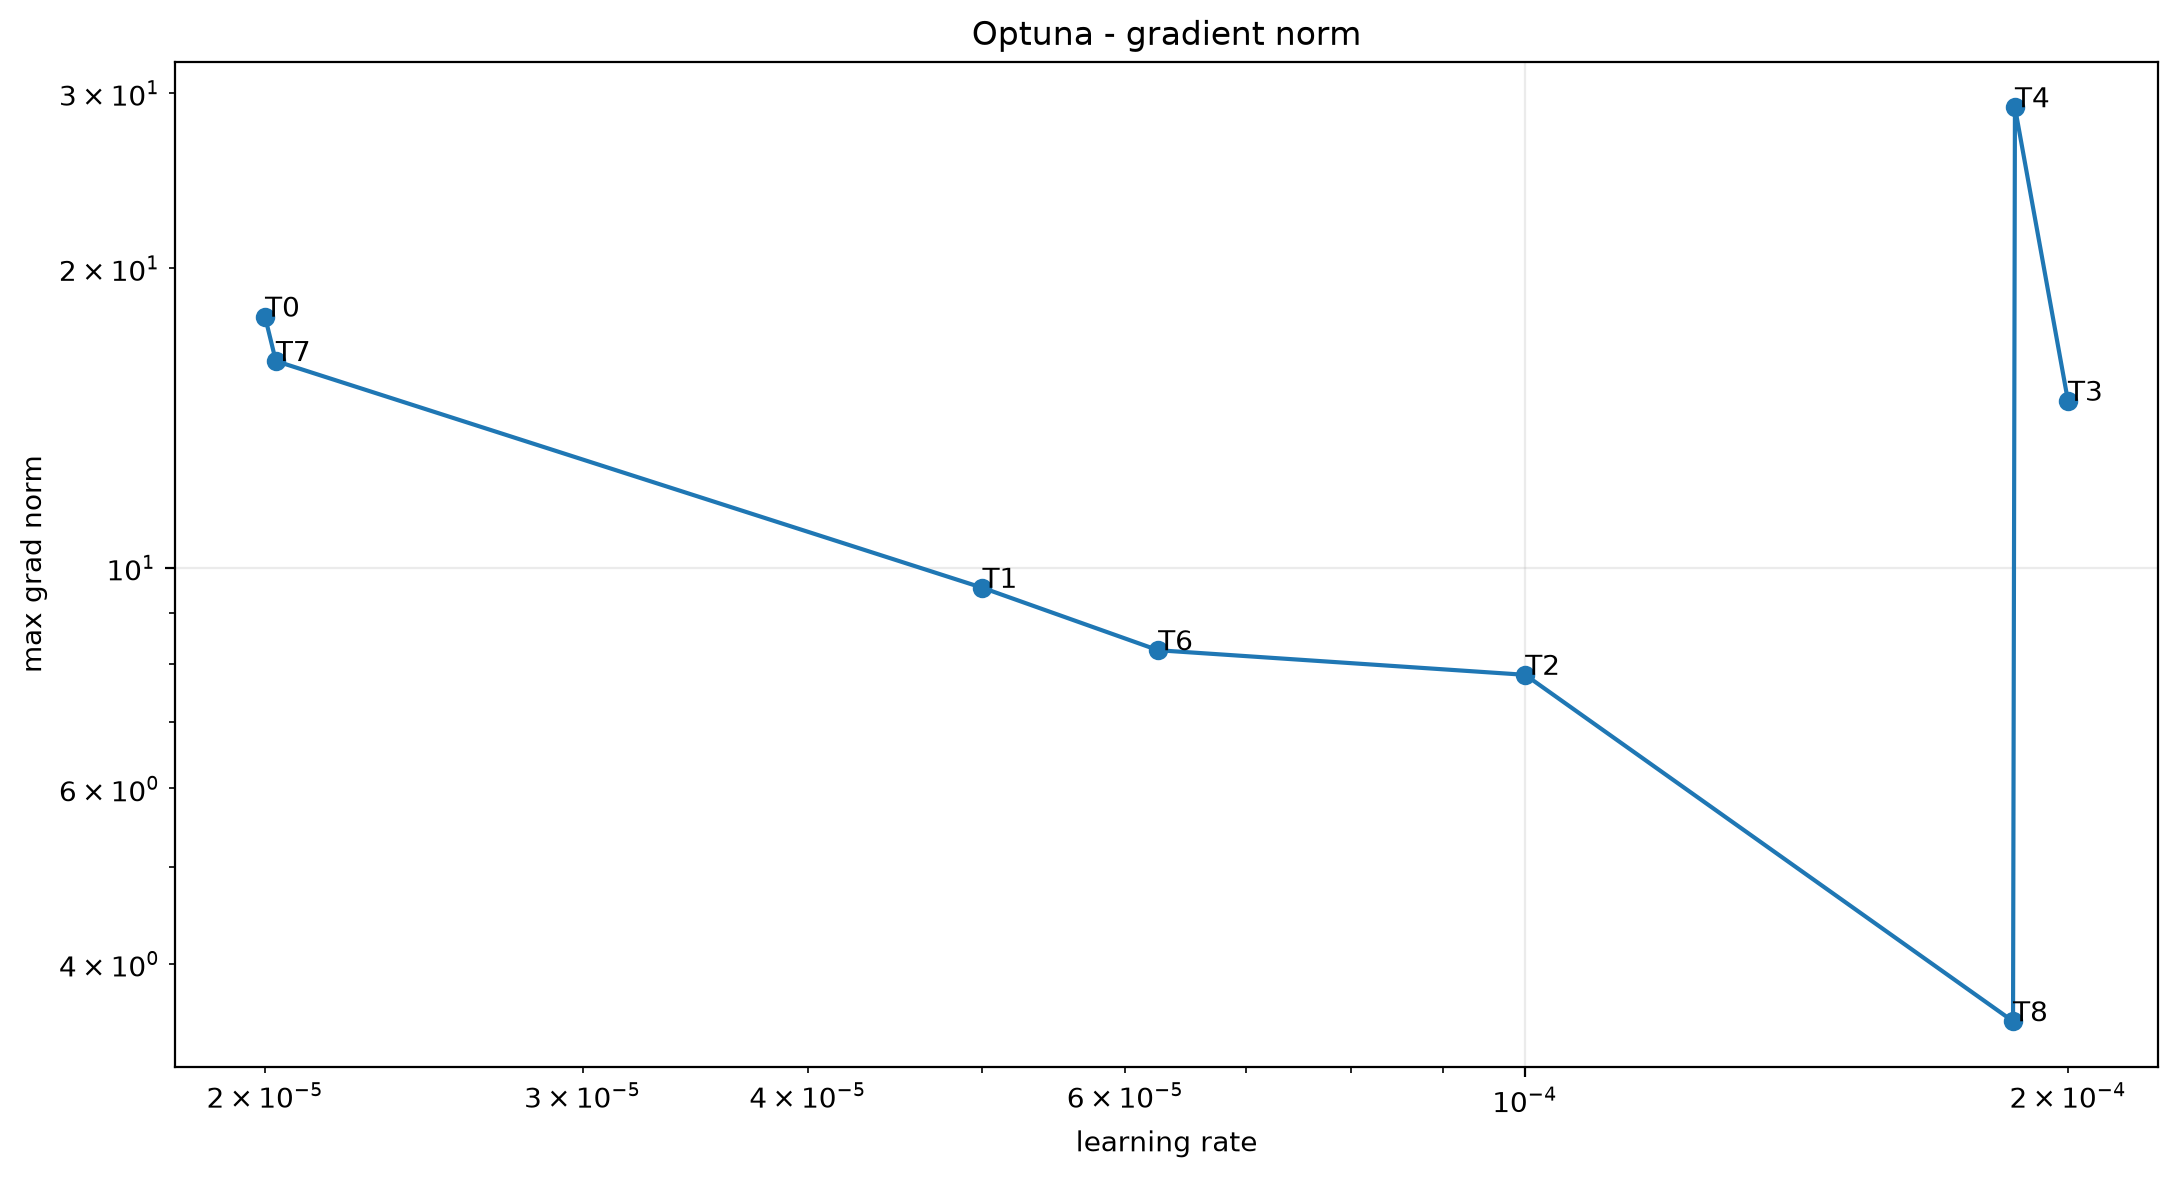
| Poradie | Trial | Learning rate | Finálny eval loss | Maximum zaznamenaného grad_norm |
|---|---|---|---|---|
| 1 | 3 | 0.0002000000 | 0.740409 | 14.7127 |
| 2 | 8 | 0.0001864520 | 0.740567 | 3.4996 |
| 3 | 4 | 0.0001869045 | 0.741250 | 29.0258 |
| 4 | 2 | 0.0001000000 | 0.752890 | 7.8035 |
| 5 | 6 | 0.0000625750 | 0.766744 | 8.2603 |
| 6 | 1 | 0.0000500000 | 0.774108 | 9.5442 |
| 7 | 7 | 0.0000202781 | 0.800064 | 16.1318 |
| 8 | 0 | 0.0000200000 | 0.800524 | 17.8756 |
Presné hodnoty LR, finálne aj minimálne eval loss, kroky, training loss a runtime sú v CSV súhrne.
Súhrn
- Najnižší finálny eval loss dosiahol trial 3 s LR 0.0002: 0.740409.
- Trial 8 s LR približne 0.00018645 dosiahol veľmi blízky výsledok 0.740567; rozdiel je približne 0.000157.
- Na tomto 30k tréningu mali nižšie skúšané LR vyšší finálny eval loss.
- Najlepší skúšaný LR leží na hornej hranici rozsahu.